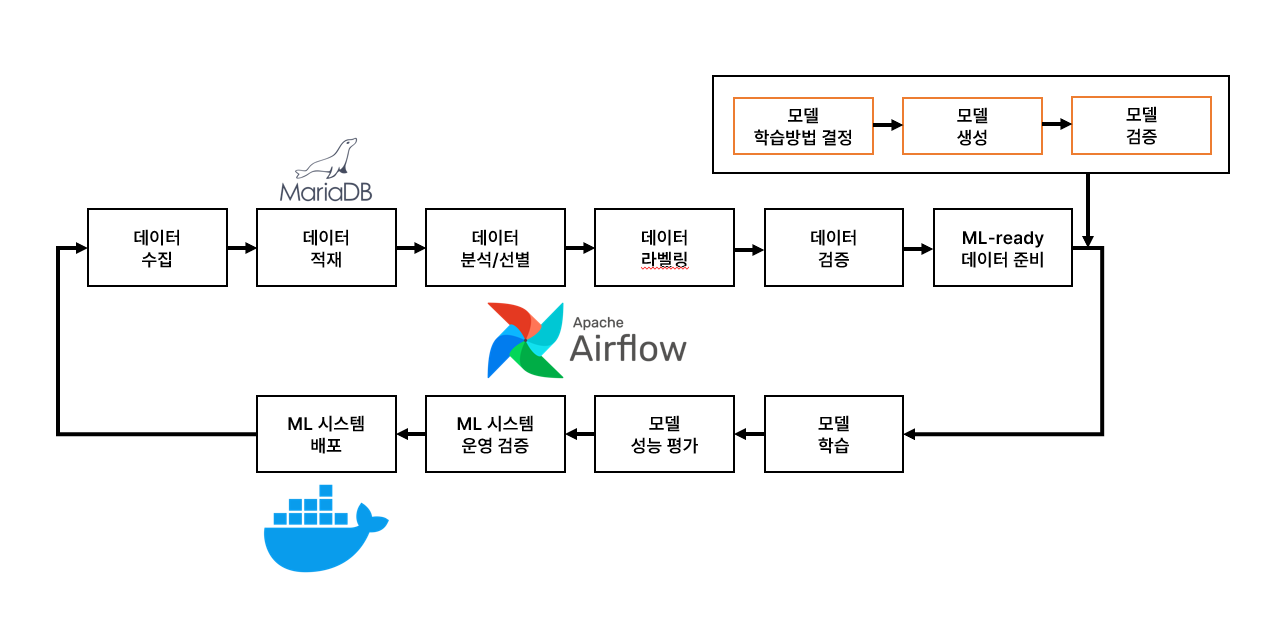
MLOps 전체 흐름 이해해보기
MLOps: 개발과 운영을 따로 나누지 않고 개발의 생산성과 운영의 안정성을 최적화하기 위한 문화이자 방법론이 DevOps이며, 이를 ML 시스템에 적용한 것이 MLOps이다.
ML 서비스를 만든다는 것은
데이터 수집 → 전처리 → 학습 → 배포 → 운영까지 전 과정을 자동으로 연결하는 것이다.
이런 전체 워크플로우를 MLOp
s(Machine Learning Operations) 라고 부른다.
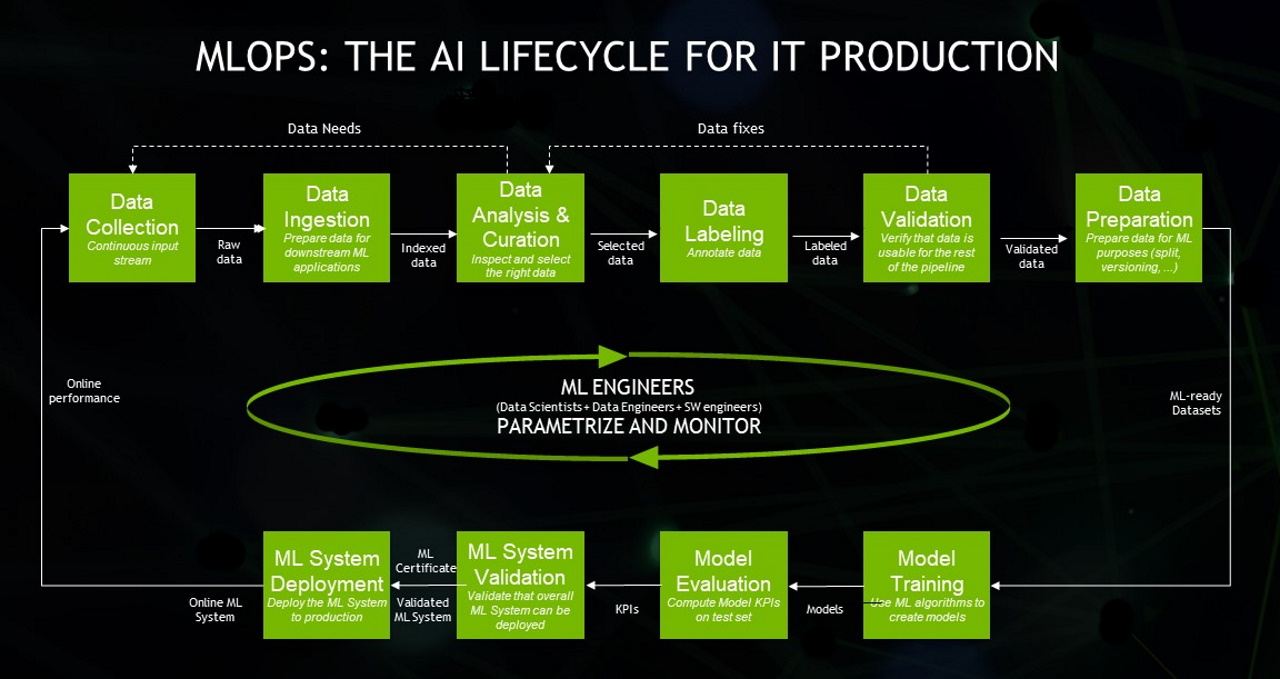
1. Data Collection — 데이터 수집
ML의 출발점은 항상 데이터다.
비즈니스 문제를 해결하기 위해 필요한 데이터를
데이터베이스, 외부 API, 센서, 로그 등 다양한 소스에서 수집한다.
2. Data Analysis — 데이터 분석(EDA)
데이터가 수집되면 우선 “무슨 데이터가 들어왔는지”를 이해하는 과정이 필요하다.
EDA(탐색적 데이터 분석)를 통해:
- 데이터의 형태와 스키마를 파악하고
- 결측치/이상치를 점검하며
- 모델에 필요한 feature가 무엇인지 탐색한다
이 단계는 이후 데이터 준비와 모델 설계의 기준이 된다.
3. Data Preparation — 데이터 준비
모델이 학습 가능한 형태로 데이터를 정리하는 단계이다.
- train/validation/test 세트로 분할
- 필요하다면 scaling, encoding 등 전처리 수행
- feature engineering을 통해 새로운 변수를 생성
ML 프로젝트 품질의 절반은 이 단계에서 결정될 만큼 중요하다.
4. Model Training — 모델 학습
준비된 데이터를 기반으로 다양한 알고리즘을 실험하고 학습한다.
- 여러 모델 구조 실험
- 하이퍼파라미터 조정
- AutoML 혹은 Grid/Random Search 활용
출력 결과는 학습된 모델 파일이며, 이는 이후 평가 및 배포의 대상이 된다.
5. Model Evaluation — 모델 평가
학습한 모델이 실제 데이터에서 어떻게 성능을 내는지 확인한다.
- hold-out test set 평가
- 정확도, F1-score, RMSE 등 task에 맞는 metric 사용
- baseline 모델과 비교해 개선 여부 확인
평가 metric은 모델 배포 여부를 결정하는 기준이 된다.
6. Model Validation — 모델 검증
평가 결과가 기준치 이상일 때 실제 서비스에 적용할 수 있는 수준인지 검증한다.
- 데이터 분포가 학습 데이터와 크게 다르지 않은지
- 성능이 안정적으로 재현되는지
- 비즈니스 요구 조건을 충족하는지
검증을 통과해야만 모델 배포가 가능하다.
7. Model Serving — 모델 서빙(배포)
검증된 모델은 실제 서비스가 사용할 수 있도록 배포된다.
- REST API로 제공되는 온라인 예측 서비스
- 정해진 스케줄에 따라 실행되는 배치 예측 시스템
- 모바일/IoT에 내장되는 embedded 모델
최근에는 Docker·Kubernetes 기반으로 배포하는 방식이 가장 널리 사용된다.
8. Model Monitoring — 모델 모니터링
배포된 모델이 시간이 지나도 정상적으로 작동하는지 감시하는 단계다.
- 예측 정확도 변화 감지
- 데이터 드리프트/feature 분포 변화 확인
- 성능 저하 시 재학습 파이프라인 트리거
ML 시스템은 한 번 만들고 끝나는 것이 아니라
계속 개선되고 업데이트되는 순환 구조라는 점에서 매우 중요하다.